Конвейер данных — это управляемый маршрут, по которому сведения о товарах проходят от источника до отчета, правила ценообразования или публикации на витрине. Для ритейла он объединяет прайс-листы поставщиков, ERP, PIM, сайты, маркетплейсы, данные о продажах и остатках, а затем приводит их к единому виду.
Конвейер товарных данных: от источника к решению
Проблема обычно возникает не на этапе загрузки. Разные системы используют собственные идентификаторы, названия атрибутов, форматы цен и статусы доступности, поэтому технически успешная передача может приводить к неверным выводам. Задача конвейера — не просто переместить строки, а сохранить смысл данных и показать, где им нельзя доверять.
Зачем бизнесу нужен конвейер данных
Разрозненные файлы и витрины создают задержки и скрытые расхождения. Цена в кабинете маркетплейса может не совпадать с внутренним прайсом, карточка — потерять обязательный атрибут, а остаток — обновиться позже, чем изменился статус товара. В такой среде аналитик тратит время на сверку, а не на принятие решений.
- мониторингировать цены конкурентов и отличать реальное изменение от ошибки сбора;
- сопоставлять продажи, остатки, ассортимент и видимость товара в разных каналах;
- готовить карточки к публикации и не пропускать записи с критическими дефектами;
- передавать в ценообразование только проверенные значения и понятный контекст;
- фиксировать историю изменений, чтобы объяснять причины расхождений.
Ценность конвейера измеряется не числом подключенных источников, а качеством решений на выходе. Если система собрала больше данных, но не различает товар, упаковку и вариант исполнения, ее масштаб увеличивает неопределенность, а не точность.
Хороший конвейер не скрывает сомнительные данные: он маркирует их, объясняет причину и не дает ошибке незаметно попасть в цену или витрину.
Из каких слоев состоит надежная схема
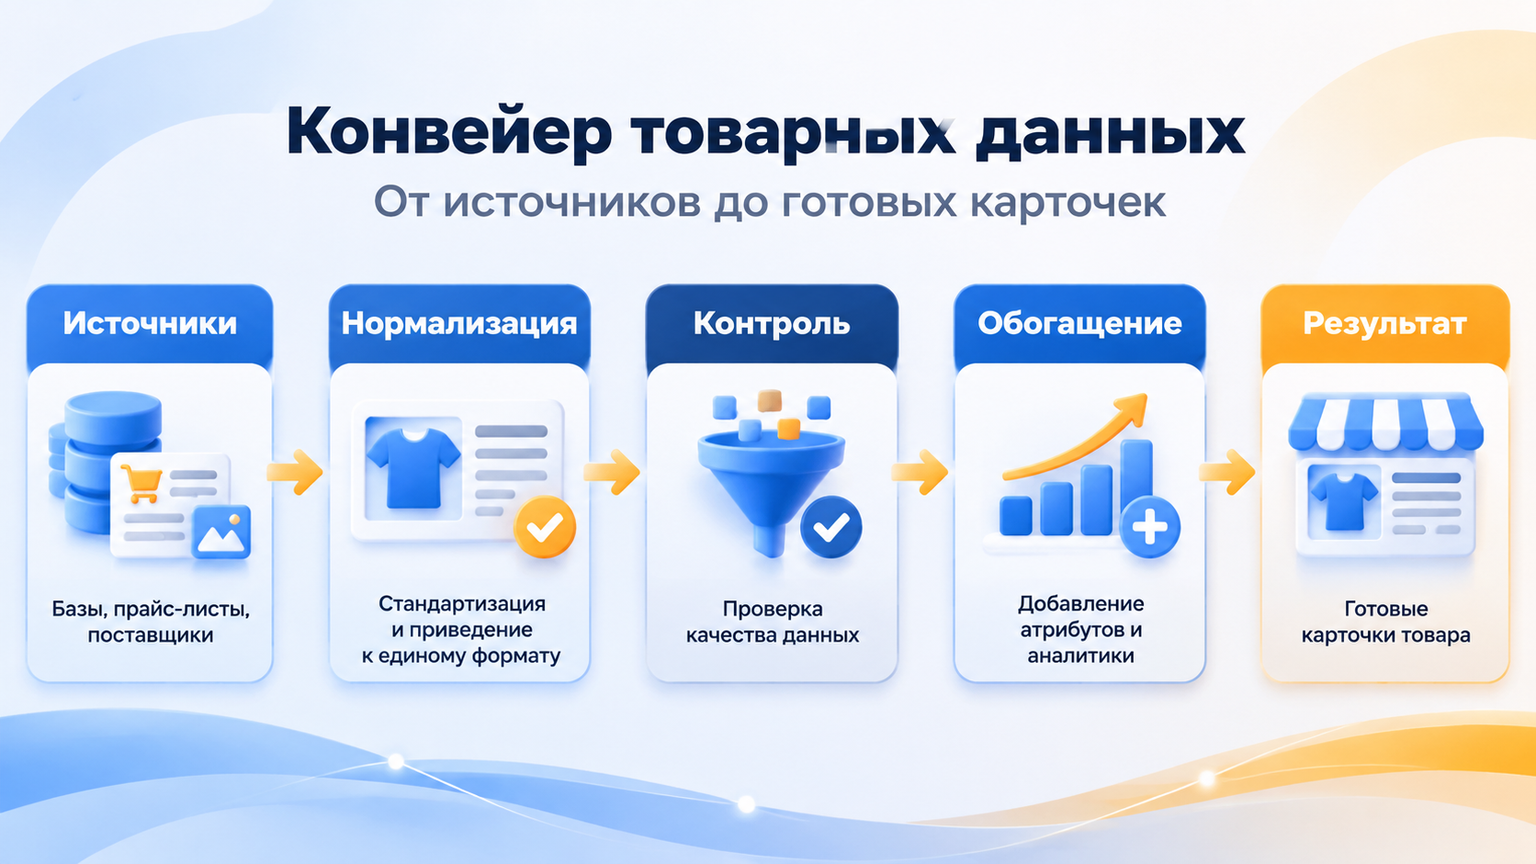
Практично разделять конвейер на независимые слои. Источник отвечает за получение, слой хранения — за сохранение исходной версии, преобразование — за приведение к общей модели, контроль — за проверку, а прикладной слой — за передачу результата пользователю или системе.
- Сбор. Принимаются API-ответы, файлы, выгрузки, веб-данные и события из внутренних систем.
- Сырая зона. Оригинальные данные сохраняются без перезаписи, вместе с временем получения и признаком источника.
- Нормализация. Поля, единицы измерения, валюты, статусы и форматы приводятся к согласованному виду.
- Обогащение. Добавляются категории, бренды, связки SKU, маржинальные показатели, признаки канала и другие расчетные поля.
- Контроль и выдача. Запускаются проверки, формируются статусы качества, после чего данные попадают в BI, PIM, мониторинг или правила цен.
Ключевой объект здесь — не файл, а модель данных. Для товара стоит заранее определить обязательные и необязательные поля, допустимые значения, связи между SKU, упаковками и вариантами, а также источник, которому доверяют при конфликте.
Минимальная модель обычно включает стабильный идентификатор товара, идентификатор продавца или канала, наименование, бренд, категорию, цену, валюту, остаток, статус доступности, дату обновления и источник. Если показатель рассчитан, нужно хранить его формулу или ссылку на правило, иначе результат трудно проверить.
Как выбрать режим обновления и архитектуру
Не всем данным нужна одинаковая скорость. Остатки и цены для активных решений требуют более свежего состояния, чем описательные атрибуты, которые меняются редко. Выбор режима делают от последствий задержки: что произойдет, если значение будет устаревшим, и допустимо ли временно не публиковать результат.
| Режим | Когда применять | Преимущества | Ограничения |
|---|---|---|---|
| Пакетная загрузка | Каталог, атрибуты, регулярные прайсы | Проще контролировать полный срез и повторный запуск | Между загрузками данные могут устаревать |
| Событийная передача | Изменения цены, остатка или статуса | Быстрее доставляет отдельное изменение | Нужны повторная доставка, порядок событий и защита от дублей |
| Запрос по требованию | Точечная проверка товара или канала | Позволяет уточнить актуальное значение перед действием | Зависит от доступности источника и ограничений запросов |
На практике используют гибридную схему: полный срез нужен для сверки и восстановления, а изменения — для оперативной реакции. При этом следует хранить время фактического получения, время изменения у источника и время публикации результата. Эти даты нельзя заменять одним полем «обновлено».
Отдельное решение — где хранить историю. Для расследования расхождений достаточно не только текущей таблицы, но и версий ключевых полей: цены, остатка, статуса, названия и идентификатора источника. История помогает отделить ошибку загрузки от корректировки поставщика или маркетплейса.
Контроль качества: что проверять до публикации
Контроль качества должен быть формализованным. Проверка «похоже на правильное» не подходит для конвейера, который влияет на деньги и доступность товара. Для каждого правила задают условие, уровень критичности, действие при нарушении и владельца исправления.
- Полнота: заполнены ли обязательные поля и не исчезли ли они после преобразования.
- Уникальность: не появились ли дубли SKU, карточек, ценовых предложений или связей.
- Согласованность: совпадают ли валюта, единицы измерения, категория и статус между слоями.
- Свежесть: не старше ли данные допустимого срока для конкретного сценария.
- Диапазоны: не выглядит ли цена, остаток, вес или габарит результатом ошибки формата.
- Связность: существует ли товар в справочнике и корректно ли сопоставлен канал.
Важно разделять блокирующие и предупреждающие ошибки. Отсутствие идентификатора, валюты или обязательного атрибута может остановить публикацию, а необычное изменение цены — отправить запись на проверку без остановки всего потока.
Для спорных значений полезно хранить не только итоговый статус, но и причину: «не найдено сопоставление», «источник старше допустимого срока», «нарушен формат», «значение изменилось сильнее порога». Такой журнал сокращает время разбора и показывает, какие правила нужно улучшить.
Перед проектированием стоит провести аудит товарных данных: он помогает увидеть пропуски, дубли и расхождения до того, как эти проблемы будут встроены в новую интеграцию.
Сценарии применения и ограничения
В мониторинге цен конвейер собирает предложения, сопоставляет товары, нормализует валюту и упаковку, а затем рассчитывает отклонения. Главный риск здесь — сравнить неэквивалентные позиции: другой объем, комплект, регион доставки или условия продажи. Поэтому результат должен содержать признак качества сопоставления, а не только числовую разницу.
В ассортиментной аналитике конвейер связывает каталог с продажами, остатками, категориями и каналами. Это помогает найти товары, которые есть в матрице, но не представлены в конкретной витрине, а также увидеть расхождения между заявленным и фактическим ассортиментом. Для анализа видимости дополнительно полезен материал о Share of Shelf на маркетплейсе.
В динамическом ценообразовании данные проходят более строгий путь: сначала проверяются свежесть и сопоставимость, затем применяются ограничения по минимальной цене, марже, запасу и роли товара. Если входные показатели неполны, безопаснее сохранить действующую цену или направить товар на ручную проверку, чем автоматически реагировать на сомнительный сигнал.
Мониторинг OOS тоже зависит от качества потока. Нулевой остаток может означать отсутствие товара, задержку обновления или ошибку сопоставления, поэтому сигнал о недоступности нужно связывать с датой сбора и надежностью источника; практический подход разобран в материале про оценку риска упущенного спроса при OOS.
Типичные ошибки проекта
- начинать с выбора инструмента, не описав бизнес-решения и владельцев данных;
- строить аналитику на названии товара вместо устойчивого идентификатора;
- перезаписывать исходные данные и терять возможность восстановить цепочку изменений;
- смешивать текущий остаток, доступный остаток и остаток на дату без явных определений;
- считать любой пропуск несущественным и не разделять уровни критичности;
- публиковать результат контроля без механизма возврата к источнику и исправления.
Еще одна ошибка — измерять успех техническими метриками: числом запросов, файлов или строк. Для бизнеса важнее доля записей, допущенных к публикации без ручной доработки, время устранения дефекта, количество невыясненных расхождений и стабильность ключевых отчетов.
Порядок запуска: от аудита к рабочему контуру
Не стоит сразу подключать все каналы и строить сложную оркестрацию. Сначала выбирают один сценарий с понятным решением и ограниченным набором полей, затем доказывают воспроизводимость результата и только после этого расширяют покрытие.
- Определите решение. Зафиксируйте, кто и что делает на основе данных: меняет цену, пополняет ассортимент, исправляет карточку или проверяет доступность.
- Опишите источники. Для каждого поля укажите систему-владельца, способ получения, частоту, дату актуальности и возможные ограничения.
- Согласуйте модель. Утвердите идентификаторы, справочники, статусы, единицы измерения, обязательные поля и правила при конфликте.
- Сохраните исходный слой. Не преобразуйте единственную копию: оставьте технические метаданные и возможность повторной обработки.
- Внедрите проверки. Начните с критичных ошибок, назначьте ответственных и настройте уведомления, которые ведут к конкретному действию.
- Проведите сверку. Сравните выборку с источниками, разберите несовпадения и проверьте поведение при пропуске, дубле и задержке.
- Расширяйте контур. Добавляйте новые каналы только после определения их идентификаторов, SLA свежести и правил качества.
Рабочая документация должна включать словарь полей, карту источников, правила сопоставления, перечень проверок, журнал изменений и порядок аварийного восстановления. Без этих артефактов конвейер быстро становится зависимым от одного специалиста, который помнит неформальные договоренности.
Итоговый критерий зрелости прост: можно ли объяснить происхождение любого показателя, воспроизвести его расчет, увидеть степень свежести и понять, какое действие следует выполнить при ошибке. Если ответ отрицательный, нужно дорабатывать не витрину отчета, а сам путь данных.